引言
在人工智能基础软件开发中,计算架构的选择直接影响模型训练与推理的效率。图形处理器(GPU)和张量处理器(TPU)是当前主流的两种加速硬件。本文从架构设计、编程模型、软件生态及适用场景等方面对二者进行比较,为人工智能基础软件的开发者提供参考。
1. 计算架构对比
1.1 GPU 架构特点
GPU 采用大规模并行计算架构,拥有数千个流处理器(CUDA Core 或 Stream Processor),适合高吞吐量的通用并行计算。其内存层次包括全局内存、共享内存、寄存器等,支持细粒度线程级并行。现代 GPU 还集成了张量核心(Tensor Core),专门加速矩阵乘加运算。
1.2 TPU 架构特点
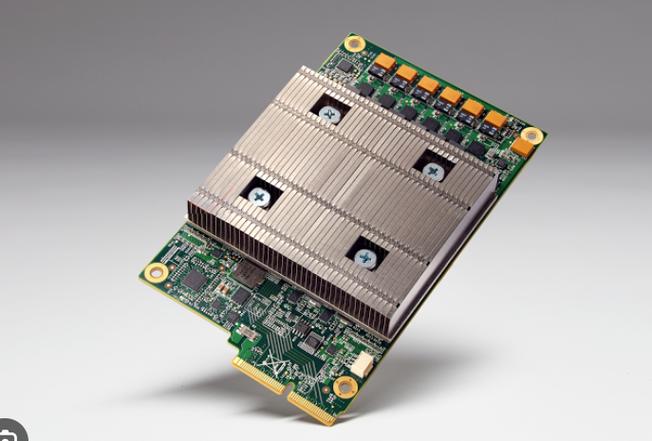
TPU 是专为神经网络计算设计的专用集成电路(ASIC)。其核心是脉动阵列(Systolic Array),以高度并行的方式执行矩阵乘法。TPU 采用大容量片上内存(如 128MB 的全局内存),减少对片外内存的访问,并通过量化技术(如 INT8)提升能效。TPU 通常以板卡或 Pod 形式部署,通过专用互连实现大规模扩展。
1.3 关键差异
- 并行模式:GPU 为 SIMT(单指令多线程),灵活但控制复杂;TPU 为脉动阵列,数据流规整,适合规则计算。
- 内存访问:GPU 依赖多级缓存和显存带宽;TPU 强调片上数据复用,降低访存开销。
- 精度支持:GPU 支持 FP32/FP16/BF16/INT8 等多种精度;TPU 侧重 BF16/INT8,对低精度优化更深。
2. 编程模型与软件栈
2.1 GPU 软件生态
- 编程接口:CUDA(NVIDIA)和 ROCm(AMD)提供底层编程能力;OpenCL 为跨平台方案。
- 高层框架:TensorFlow、PyTorch 等通过 cuDNN、cuBLAS 等库调用 GPU 加速。
- 灵活性:开发者可定制核函数,优化特定算子,适合研究探索和自定义模型。
2.2 TPU 软件生态
- 编程接口:通过 XLA(加速线性代数)编译器将高层框架的计算图编译为 TPU 指令。
- 框架支持:TensorFlow 原生支持 TPU;PyTorch 通过 XLA 桥接支持。
- 使用方式:通常以云计算服务形式提供(如 Google Cloud TPU),开发者通过 API 调用。
- 限制:定制化程度较低,不适配非矩阵运算密集的模型。
2.3 基础软件开发考量
- 算子库:GPU 生态拥有丰富的优化算子库;TPU 依赖 XLA 自动编译,对动态形状支持有限。
- 调试与性能分析:GPU 工具链(如 Nsight)成熟;TPU 性能分析工具相对较少。
- 部署灵活性:GPU 可本地部署,TPU 多依赖云服务。
3. 适用场景与选择建议
3.1 GPU 适用场景
- 需要高度定制化模型或自定义算子的研究。
- 多模态任务、动态计算图、小批量推理等不规则计算。
- 本地开发和小规模部署。
3.2 TPU 适用场景
- 大规模矩阵运算密集的模型(如 Transformer、CNN)训练。
- 对能效和成本敏感的大规模推理。
- 已基于 TensorFlow/XLA 构建的流水线。
3.3 选择建议
在人工智能基础软件开发中,若追求灵活性和生态丰富度,GPU 是稳妥选择;若模型规整且需极致性能功耗比,可考虑 TPU。混合使用(如 GPU 训练、TPU 推理)也成为趋势。
结论
GPU 和 TPU 代表了通用并行与专用加速两种设计哲学。理解其架构差异和软件生态特点,有助于在人工智能基础软件开发中做出合理的技术选型,并针对性地优化软件栈,充分发挥硬件潜力。随着编译技术(如 XLA、MLIR)的发展,二者在软件层面的界限正逐渐模糊,未来基础软件将更注重跨架构的抽象与自动优化。